בחינת רובאי ראייה בפיקוח עצמי לזיהוי הליכה ב-The Wild חלק 2
Nov 24, 2023
2.2. Vision Transformers
למרות שהוצעו בתחילה למשימות NLP [16,34] בהצלחה עצומה, שנאים הפכו בשימוש נרחב בראייה ממוחשבת בשנים האחרונות [24,25,28,35-37]. שני התחומים נהנו מביצועים חסרי תקדים על ידי שימוש בווריאציות שונות של שנאים, חלקית בשל קיבולת המודל המוגברת ויכולת השנאים להפיק תועלת מפיקוח עצמי הרבה יותר מאשר דגמים קודמים [17].
ניטור עצמי וזיכרון קשורים קשר הדוק. ניטור עצמי מתייחס להערכה והתאמת ההתנהגות, החשיבה והרגשות של האדם, בעוד שזיכרון מתייחס ליכולת לרכוש, לעבד ולאגור מידע. ניטור עצמי יכול לעזור לנו להשיג שליטה טובה יותר על ההתנהגות והרגשות שלנו, ובכך לשפר את הזיכרון.
ראשית, ניטור עצמי יכול לעזור לנו לעמוד טוב יותר בפיתויים. הפיתוי נוטה להסיח את תשומת הלב והאנרגיה שלנו ולהשפיע על הזיכרון שלנו. באמצעות ניטור עצמי, אנו יכולים לשלוט טוב יותר בעצמנו ולהימנע מהסחות דעת מוגזמות, ובכך לשפר את הזיכרון.
שנית, ניטור עצמי יכול גם לעזור לנו להבין ולזכור מידע טוב יותר. ניטור עצמי מאפשר לנו להקדיש יותר תשומת לב לנקודות המפתח של המידע ולשים לב לקשרים בין מידע, כדי להבין טוב יותר מידע ולזכור אותו. כאשר אנו שמים לב, אנו מצוידים טוב יותר להבין ולשמר מידע.
לבסוף, ניטור עצמי יכול גם לעזור לנו להתבונן ולסכם טוב יותר את ההתנהגות והחשיבה שלנו. על ידי הרהור על פעולותינו ותהליכי החשיבה שלנו, אנו יכולים לזהות חסרונות ולשפר אותם. שיפור זה לא רק משפר את ההתנהגות והחשיבה שלנו אלא גם משפר את יכולות הזיכרון שלנו.
לסיכום, ניטור עצמי וזיכרון קשורים קשר הדוק. באמצעות ניטור עצמי, אנו יכולים לשלוט טוב יותר בעצמנו, להבין ולזכור מידע טוב יותר ולשפר טוב יותר את ההתנהגות ותהליכי החשיבה שלנו. יחד עם זאת, זה גם יעזור לנו לשפר את הזיכרון שלנו, יאפשר לנו ללמוד ולעבוד בצורה יעילה יותר. תנו לנו להבהיר את המטרות שלנו, להתאים את עצמנו באופן פעיל ולרדוף כל הזמן אחר התקדמות! ניתן לראות שאנו צריכים לשפר את הזיכרון, ו-Cistanche deserticola יכולה לשפר משמעותית את הזיכרון, מכיוון ש-Cistanche deserticola יכולה לווסת גם את איזון הנוירוטרנסמיטורים, כמו הגדלת רמות האצטילכולין וגורמי גדילה. חומרים אלו חשובים מאוד לזיכרון וללמידה. בנוסף, בשר יכול גם לשפר את זרימת הדם ולקדם אספקת חמצן, מה שיכול להבטיח שהמוח יקבל מספיק חומרים מזינים ואנרגיה, ובכך לשפר את חיוניות המוח וסיבולת.

לחץ על יודע תוספי מזון כדי לשפר את הזיכרון
Dosovitskiy et al. [24] היו הראשונים שהציעו שימוש במקודדי שנאים לסיווג תמונה, והציגו את Vision Transformer (ViT). הארכיטקטורה מחלקת את תמונת הקלט לטלאים בגודל קבוע של 16x16, משטחת ומקרינה אותם בשכבה לינארית למימד ההטמעה. אסימון מחלקה נוסף (CLS) מוכנס לרצף וקידוד מיקום מתווספים לכל וקטור.
רצף ההטמעות המתקבל ניתן כקלט למקודד שנאי, בעל אותו מבנה כמו זה שב[34] אך משתמש באופרטור LayerNorm לפני כל בלוק במקום אחרי (טרום-נורמה). MLPhead משמש כדי להשיג את תווית הכיתה מהמידע המצטבר גלובלי באסימון הכיתה.
מנגנון הקשב העצמי שהוצג על ידי Vaswani et al. [34] לוקח רצף של פריטים כקלט ומעריך את האינטראקציה בין כולם על ידי צבירת המידע הגלובלי עבור כל אלמנט ברצף. כדי לחשב אינטראקציות שונות בין מרכיבי הרצף, מודול הקשב העצמי הרב-ראשי (MSA) משרשר את התוצאות של מספר בלוקים של קשב עצמי ומקרין את הפלט על מטריצת משקל הניתנת ללמידה. מקודד השנאי שהוצג ב-[34] מורכב משכבות מוערמות מרובות המורכבות מבלוק MSA, בלוק הזנה קדימה (FFN), חיבורים שיוריים בין כל בלוק ו-LayerNorm (LN) לאחר כל בלוק.
Touvron et al. [25] מציעים שני שינויים ארכיטקטוניים לשיפור הביצועים של שנאי ראייה עמוקה. התרומה הראשונה שלהם, LayerScale, מקלה על אימון מודלים עמוקים יותר על ידי הוספת מטריצה אלכסונית ניתנת ללמידה המוכפלת בפלט של בלוקים השיוריים. מכיוון שהמטריקס מאותחל עם ערכים קטנים, היא מאלצת את התוצאות של שכבות מקודד השנאים בעלות תרומה קטנה לפלט של הבלוק השיורי בתחילת האימון.
תרומתם השנייה היא מנגנון תשומת הלב המעמדית. במקום להוסיף תחילה את אסימון ה-CLS, כמו ב-ViT הסטנדרטי, הוא מצורף לאחר מספר בלוקים מקודד. לאחר שלב זה, רק אסימון הכיתה מתעדכן ואסימוני התיקון נשמרים קפואים. מנגנון זה מסייע באי-הצמדה של פעולות הקשב העצמי בין טלאים לצבירה של המידע שישמש לסיווג.
יואן וחב'. [28] טוענים שהאסימון הפשוט של טלאים ב-ViT של הווניל יש את המגבלה של אי-יכולת לדגמן את המבנה המקומי של התמונה ואת האינטראקציה בין טלאים שכנים. כתוצאה מכך, הם מציגים תהליך אסימונים מתקדם המשלב אסימונים שכנים לאחד.
תהליך זה מורכב ממודול Reshape, שלוקח את רצף האסימונים מהשכבה הקודמת ובונה מהם תמונה על סמך קרבה מרחבית. מודול Soft Split מחלק את התמונה הבנויה לטלאים חופפים של אסימונים ומזין אותם למקודד הבא. האסימונים שנוצרו לאחר תהליך הטוקניזציה מוזנים לתוך עמוד שדרה צר ViT עמוק לסיווג.

כפי שציינו Wang et al. [35] ה-Vision Transformer הסטנדרטי תוכנן במיוחד עבור סיווג תמונה ואינו מתאים למשימות אחרות כגון פילוח זיהוי אובייקטים. בשל כך, הם מציעים את Transformer (PVT) של Pyramid Vision השואב השראה מארכיטקטורות CNN על ידי הפקת מפות תכונה מתווך עם מימדים מרחביים פוחתים ומספר הולך וגדל של ערוצים.
מבנה פירמידה זה מסייע למודל בלימוד תכונות מרובות קנה מידה שניתן להשתמש בהן עבור משימות שונות. המודל מעבד תחילה אסימונים המתקבלים מטלאים במידות 4 × 4, ובכל שלב, האסימונים מתאימים לממדים מרחביים גדולים יותר של טלאים.
העלות החישובית של תשומת לב עצמית קלאסית היא O(N2·d) כאשר N הוא מספר האסימונים ברצף ו-d הוא הממד הווקטורי. העלות החישובית הריבועית במונחים של מספר האסימונים הופכת לבעיה מעשית עם הגדלת רזולוציית תמונת הקלט מכיוון שכל אסימון ברצף מתאים לתיקון בתמונה.
בספרות, ישנן מספר טכניקות שבאמצעותן ניתן להפחית את העלות החישובית של תשומת לב עצמית וניל [26,35,36]. PVT [35] משתמש בתשומת לב להפחתה מרחבית, אשר מקטין את הגודל המרחבי של וקטורי המפתח והערך לפני הקשב העצמי עם פעולת עיצוב מחדש והשלכה ליניארית.
שנאי Swin [36] שיש לו גם מבנה פירמידה מחליף את בלוק הקשב העצמי במודול שמתקרב אליו. המודול מקבץ טלאים שכנים בחלונות מקומיים ומבצע את פעולת הקשב העצמי רק בתוך חלונות אלו.
כדי לתקשר את המידע עם חלונות אחרים, הוא מסיט את החלונות המקומיים כך שהם מכילים גם תיקונים מחלונות שכנים ומחשב שוב תשומת לב עצמית. Chu et al. [27] אימץ את ארכיטקטורת ה-PVT והציע שיטה דומה לקירוב תשומת לב עצמית. הם גם ביצעו תשומת לב מקומית בין טלאים בחלון, בדומה לשנאי Swin.
כדי לתקשר מידע עם חלונות אחרים, הם ערכו תשומת לב עצמית בין נציג של כל חלון וכל שאר החלונות. CrossFormer [26] מתבסס גם על ה-PVT. הוא משתמש בקשב למרחקים קצרים, הדומה לתשומת הלב המקומית בשנאי Swin, אך לצורך דליפת מידע לחלונות אחרים הוא משתמש בקשב למרחקים ארוכים, אשר מחשב את האינטראקציה בין טלאים, שיש ביניהם מרחק קבוע. הוא גם משלב תיקונים בקנה מידה מרוכז סביב אותו פיקסל כדי להשיג את האסימונים עבור בלוקי השנאי, מה שעוזר למודל בלימוד אינטראקציות בקנה מידה.
יאנג וחב'. [37] מציעים את מנגנון הקשב המוקד ללימוד אינטראקציות קצרות וארוך טווח בין אסימונים, מה שהופך את שנאי הראייה מסוגלים לעבד תמונות ברזולוציה גבוהה. עבור כל תיקון תמונה, מודול הקשב העצמי המוקד מחשב אינטראקציות עם טלאים סגורים מרחבית ועם חלונות מסוכמים של טלאים מרוחקים יותר. הסיכום של חלונות של טלאים נעשה באמצעות איגום והוא לוכד מידע ללא מידע כאשר הטלאים רחוקים.
ה-RegionViT [38] משתמש בארכיטקטורת PVT ומוסיף שני נתיבי טוקניזציה עבור כל מפת תכונה. נתיב האסימון הראשון משיג אסימונים אזוריים המורכבים מטלאים המכסים מספר רב של פיקסלים. נתיב האסימון השני משיג אסימונים מקומיים הלוכדים מידע ברמה נמוכה על ידי מכילים מעט פיקסלים. שני סוגי האסימונים הללו מוזנים כקלט למקודד השנאי אזורי-למקומי שבו מחושבת תשומת לב עצמית ראשונה בין אזורים, ואז בין כל אסימון אזורי לאסימונים המקומיים המתאימים לו.
ארכיטקטורת LeViT [39] משלבת גם CNN וגם את מנגנון הקשב העצמי. תמונה מוזנת תחילה לתוך מקודד CNN, מה שמקטין את הממדים המרחביים ומגדיל את מימד הערוץ. מפות התכונות המתקבלות מוזנות ל-hierarchicalViT שמכיל מודול תשומת לב מתכווץ בין המקודדים שלו כדי להקטין עוד יותר את הממדים המרחביים ולהגדיל את ממד הערוץ של מפות התכונות.
ארכיטקטורות המבוססות על תשומת לב הופעלו גם במשימות מבוססות וידאו שבהן יש לקחת בחשבון מידע זמני. ארכיטקטורות, כגון ViViT [40] ו-TimeSformer [41], מנצלות את מנגנון הקשב העצמי על פני הממדים המרחביים והזמניים כאחד. בגלל זה, המודל לומד ללכוד את המידע המרחבי מכל פריים ואת השינוי לאורך זמן.
3. שיטה
בחלק זה, אנו מספקים תיאור מפורט של כל ארכיטקטורה ושל הפרמטרים ההיפר שנבחרו. בנוסף, אנו מתארים את עיבוד הנתונים ואת החלטות התכנון המוצעות להתאמת שנאי ראייה לעבודה עם רצפי שלד. לבסוף, אנו מתארים את שיטות האתחול, פרוטוקול ההערכה ומערכי הנתונים של הערכה.
3.1. תיאור אדריכלות
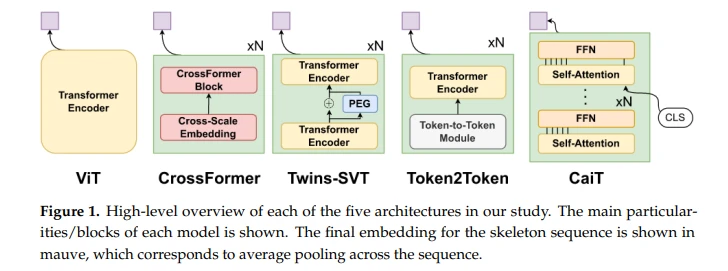
חקרנו חמש גרסאות שונות של Vision Transformers (איור 1), שפותחו עבור חישוב אופטימלי יותר על תמונות, במונחים של ביצועים במורד הזרם וזמן ההסקה. בפרט, אנו חוקרים את ה-ViT הקלאסי [24], CaiT [25], Token2Token ViT [28] ו-Twins-SVT [27].
באופן כללי, הטעמים של שנאי ראייה עוסקים בשיפורים בדרך ה"קלאסית" של עיבוד תמונות עם שנאים, כפי שהוצע ב-ViT: תמונות מפוצלות לטלאים שווים בגודלם ולא חופפים, אשר משטחים ומוקרנים לתוך חלל ממדי נמוך יותר. לאחר מכן יטופלו כ"אסימונים", באופן דומה ליישומי NLP. במקרה של ניתוח הליכה, תיקון מרובע מתאים לקבוצת מפרקים המשתנים על פני חלון זמני קטן.
מקודד השנאי הסטנדרטי לוקח כקלט רצף של פריטים (X ∈ Rn×d שבו - מספר פריטים, d - ממד הטמעה) ומקרין אותם על שלוש מטריצות משקל ניתנות ללמידה שונות ומשיג את השאילתות (Q ∈ Rn×dq), המקשים (K ∈ Rn×dk, dk=dq),וערכים (V ∈ Rn×dv ), כאשר dq, dk ו-dv הם הממדים עבור השאילתות, המפתחות והערכים, בהתאמה. תשומת הלב מחושבת כך:

עבור רוב הארכיטקטורות, תיקנו את מספר השכבות, ראשי הקשב ומאפייני המאפיינים במידת האפשר. ככזה, אנו בוחרים 4 שכבות עם 4 תשומת לב headseach, ממד של 512 עבור רשת ההזנה, וגודל הטמעה סופי של 128.

ViT The Vision Transformer [24] משיג רצף קלט של אסימונים על ידי חלוקת התמונה לטלאים והקרנה ליניארית שלהם למימד ההטמעה. הרצף המתקבל יחד עם אסימון מחלקה נוסף (CLS) ניתן כקלט למקודד שנאי. יתר על כן, מקודד ViT משתמש בקדם-נורמה, בניגוד לאחר נורמליזציה. ניתן לחשב את הפלט של שכבה כך:

כאשר λl, i ו-λ0l, הם פרמטרים הניתנים ללמידה. המודל גם מנתק את החישוב של אינטראקציות בין אסימוני קלט מהחישוב של הטבעת המחלקה שמאגדת את כל המידע הגלובלי. זה נעשה עם תשומת לב כיתתית אשר מציגה את אסימון ה-CLS לרצף הקלט לאחר שהתקבלו האינטראקציות ומקפיאה את כל האסימונים האחרים. עבור מקודד CaiT, השתמשנו באותה תצורה כמו ב-ViT, אבל עבור מקודד CLS, השתמשנו בעומק של 2 שכבות.
Token2Token ViT ארכיטקטורת Token2Token [28] מכילה תהליך טוקניזציה פרוגרסיבי שמדגמן את המבנה המקומי של תמונה על ידי שילוב של אסימונים שכנים. תהליך האסימון בונה תחילה מבנה דמוי תמונה מרצף קלט של אסימונים בעזרת מודול Reshape. לאחר מכן התמונה מחולקת לטלאים חופפים של אסימונים באמצעות מודול Soft Split (SS). הפלט המתקבל ממודול הטוקניזציה מחושב כך:
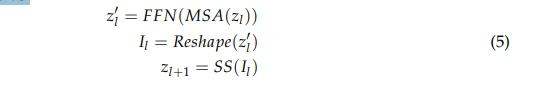
עבור Token2Token, השתמשנו ב-2 שכבות עם גדלי תיקון של {2, 8} ו-{2, 4} עבור השכבה הראשונה, ו-{4, 16} עבור השכבה השנייה.
Twins-SVT ארכיטקטורת Twins-SVT [27] מחליפה את בלוק הקשב העצמי הקלאסי במודול הנקרא תשומת לב עצמית מרחבית (SA) שמקרוב את הפעולה. SSSA מורכב מתשומת לב עצמית מקובצת מקומית (LSA) אשר מחשבת את אינטראקציה רק בין אסימונים בתוך אותו חלון מקומי לבין תשומת הלב הגלובלית תת-דגימה (GSA) אשר צוברת מידע גלובלי על ידי ביצוע תשומת לב עצמית בין כל הנציגים של כל חלון מקומי המחושבת על ידי סיבוך של האסימונים השכנים. ניתן לכתוב את הפעולות של שכבת aTwins כך:

עבור מקודד CrossFormer, השתמשנו בממדים של {16, 32, 64, 128} עבור השכבות, גדלים גלובליים של חלונות של {4, 2, 2, 1}, גודל חלון מקומי של 2, צעדים מוטבעים של 2, וצלבים -הטמעת גדלי ליבה של {{2, 4, 8, 16}, {2, 4}, {2, 4}, {2, 4}}.
3.2. עיבוד מקדים של נתונים
הן עבור מערכי נתונים של DenseGait והן עבור GREW, אנו משתמשים באותו הליך עיבוד מקדים. עבור כל רצף שלד שחולץ ונעקב המכיל 18 מפרקים עם קואורדינטות x, ו- y וציון ביטחון נוסף, תחילה אנו מנרמלים את הרצף על ידי ריכוז בקואורדינטות האגן (אגן, אגן) ועל ידי שינוי קנה מידה אופקית ואנכית, לפי פרופורציות הגוף האנושיות (כלומר, המרחק בין הכתפיים: |xR.shoulder − xL.shoulder| והמרחק מהצוואר לאגן: |צוואר − ypelvis|). עבור כל קואורדינטה (מפרק, מפרק) של כל אחד מ-18 המפרקים בפורמט תנוחת COCO, אנו מיישמים את הליך הנורמליזציה הבא:
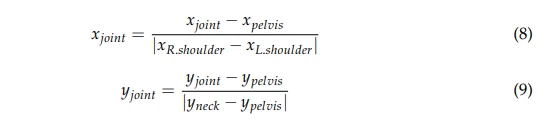
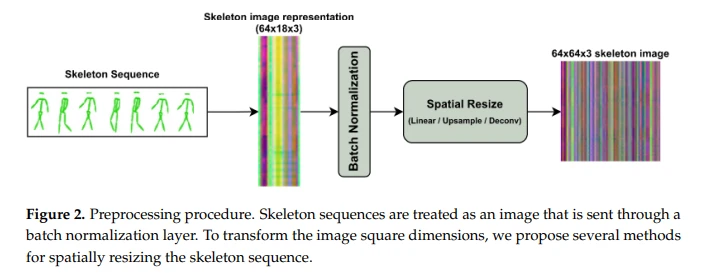
באמצעות תהליך הנורמליזציה, הבדלים בין רזולוציות המצלמה והמרחק של הנבדק מהמצלמה מתבטלים. יתרה מכך, אנו מבטלים מידע על המראה לגבי הגובה והרוחב של נושא, שאינם נוגעים למידע על תנועה. שלב זה דומה לשלב היישור במודלים מודרניים של זיהוי פנים [42]. יתר על כן, אנו גם משתמשים בשכבת נורמליזציה אצווה [43] בתחילת כל מודל כדי לנרמל עוד יותר את התמונה המתקבלת.
בהינתן הממד הטמפורלי T (כלומר, מספר הפריימים) והממד המרחבי של השלד J (כלומר, מספר המפרקים), רצפי שלד תמימים מקודדים כתמונות של צורה (T, J, 3), כאשר במקרה שלנו, T {{ 1}} ו-J=18.

רוב שנאי הראייה, לעומת זאת, מניחים שהתמונות מרובעות. לכן, אנו מציעים וריאנטים מרובים של שינוי גודל הממד המרחבי, כך שהתמונה תהפוך ל- (T, T, 3), וזה שווה ערך להגדלה מלאכותית של מספר המפרקים (ראה איור 2).
For more information:1950477648nn@gmail.com